


AIやその活用にはリスクがあり、それをゼロにすることは極めて困難です。AIのリスクを正しく理解し、1つひとつ適切な対策を行えば、ゼロにはできなくとも、リスクを回避したり低減させたりしながらAIプロジェクトを前に進められます。そのために企業は、必要な体制やプロセスを全社横断で整え、道具を準備する必要があります。書籍『 AIリスク教本 改訂新版 AIエージェント&フィジカルAI AI新時代のガバナンス 』(日経BP)から抜粋し、典型的なAIリスクと必要な対策について解説します。第3回では、AIリスクが生じるメカニズムについて説明します。
AIの活用は事業を新たな領域に広げたり業務を大幅に効率化したりできる可能性があります。その一方で活用が進むほどリスクの問題も増えています。そもそもなぜAIにリスクが生じるのでしょうか。
原因はAIの開発に用いている「帰納的アプローチ」と、人間に似通った能力を持っている、あるいは持っていると思われている性質にあります。
AIを含めコンピューターのソフトウエア開発は、演繹(えんえき)的アプローチと帰納的アプローチに大別できます(図)。
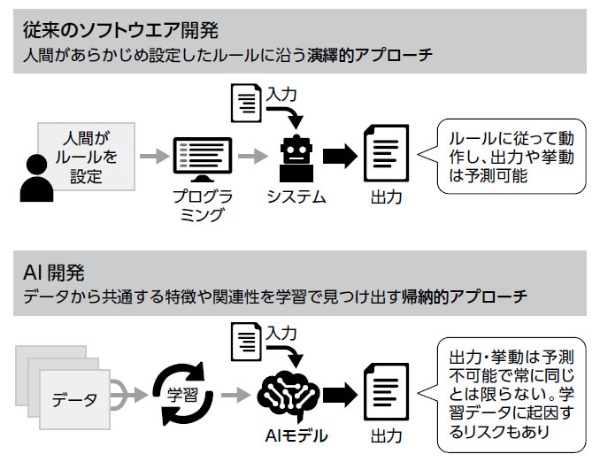
通常のコンピューターソフトウエアは人間(開発者)が設定したルールをプログラム(計算処理の手順)に書き出します。できたプログラムで入力データの分析処理を実行し、出力します。プログラムを先に作って、ロジックを組み合わせて入力データを処理するので演繹(えんえき)的アプローチとなります。
一方、現代のAIの根幹技術である機械学習で作られるプログラム=AIモデルはそれとは真逆の帰納的アプローチです。あらかじめ用意したデータに共通する特徴や関連性を表現したAIモデルが自動的に学習で作り出されます。このAIモデルに入力データを与えて分析処理するのです。先にデータがあってそこからプログラムを作り出すので帰納的アプローチとなります。
このアプローチの違いが従来のソフトウエアと、機械学習を用いたAIの品質管理やリスクに、大きな違いを生んでいます。
品質管理が確立している従来の演繹的アプローチ
従来のソフトウエア開発では、どのような計算処理を行うアルゴリズムにするかをソフトウエア開発者が設計し実装します。そのため入力データに対してプログラムがどのような挙動を示すかソフトウエア開発者は把握しており、事前に挙動の予想が可能でした。
組み合わせが大量になる場合はあるにしても、プログラムのすべての処理を漏れなく検査するテストケースを定義し、プログラムに与えると、プログラムにバグがないことが確認できました。テストケースとは、プログラムが正常に作動し、高レベルの品質で構築されていることを確認するために検証すべき内容、テストの条件や実行手順、期待する結果などをまとめたものです。
ソフトウエア開発の歴史では、開発やテスト、品質管理の方法論がソフトウエア工学の一分野として確立し、実践されてきたのです。この世界では、プログラムにバグ、すなわち特定の入力データに対してすべきではない挙動を起こす間違いが含まれていたら、開発者はプログラムのその原因となっている部分を直接修正できました。
もしプログラムに倫理的に問題のある挙動が見られたなら、それは開発者の意図だと見なせました。プログラム開発者が関与し、問題のある挙動を意図的に埋め込まないと起こるはずがないからです。開発者に意図がなかったとしたら、開発プロセスやプログラム自体にセキュリティー上の問題があり、悪意を持った外部の開発者がプログラムにアクセスした場合に発生したことを意味していました。
さらにこうしたリスクも、ソフトウエア工学の一部として確立したソフトウエア品質管理のプロセスによって防ぐことができていました。
帰納的アプローチだから従来の手法が通用しない
一方で、機械学習を用いるAIの開発は従来のソフトウエア開発とはまったく異なる帰納的アプローチです。そのため従来のソフトウエア工学の考え方がそのままでは通用しない部分があります。
機械学習工学[1]やMLOps(エムエルオプス)と呼ばれる新しい方法論が生まれ、確立されつつあります。MLOpsは機械学習(Machine Learning)と運用(Operations)を組み合わせた造語で、機械学習モデルやAIモデルを一度作っておしまいではなく、継続的に本番運用していく仕組みや考え方です。ただし、生成AIを含む近年のAI技術の進歩があまりに速く、AIの品質を管理する手法は、分野や用途により成熟度に差があるのが現状です。
[1] 石川 冬樹, 丸山 宏 編著,「機械学習工学」, 講談社 機械学習プロフェッショナルシリーズ, 2022年7月20日
帰納的アプローチによって開発されるプログラム(AIモデル)は従来とどう異なり、どういう問題が生じるのでしょうか。
AIは学習データから共通する特徴や関連性を見つけ出す推論によりAIモデルを作り出します。出来上がったAIモデルに別の入力を与えて目的の出力を得ます。
AIの開発でも学習データの特徴をどのように表現するかというAIモデルの構造は開発者が設計します。しかしAIモデル自体は学習データの統計的な処理により自動的に作成されるため、学習されたモデルの動作の把握は開発者であっても困難です。学習データが同じでも同じAIモデルが学習されるとは限りません。これらの点が従来の演繹(えんえき)的アプローチでのソフトウエア開発と大きく異なるのです。
AIモデルでは、期待通りに動作するようにできているかを検査するためのテストケースの定義が困難です。プログラムとしてはバグがないと確認できたとしても、AIモデルとしての挙動に問題があるかもしれません。統計的に振る舞うため問題の再現にも苦労します。問題が見つかったとしても、バグの修正(デバッグ)は容易ではありません。プログラムとしては正しく動作しているので、その問題が生じる箇所を直接修正できないからです。
学習データに偏見や差別的な内容が含まれていたために、倫理的に偏りを含んだ内容が出力される可能性もあります。1つの修正方法は、問題の原因となっている学習データの修正や削除ですが、最近の生成AIでは膨大な学習データを使うため、そこから問題の原因となっているデータを特定するのは困難です。
結果的に、データやAIモデル自体の修正は諦めて、対症療法的な対応を取ることになりがちです。これはシステムとしてAIモデルへの入力や出力を変更して場当たり的な対応をするようなロジック(処理手順)を組み込むやり方です。
AIが人間と似通っている、あるいは似通っていると期待されていることに起因するリスク
AIリスクの別の原因に「AIが人間と似ている」ということがあります。
AIの利用目的はそもそも、機械による人間の知能の一部の肩代わりなので、AIの挙動や能力がある程度人間に似通っている、あるいは似通っていると期待されるのは、AIの定義の一部であるといえます。
しかしその結果、AI(やその出力)を人間と混同するリスク、人間の代わりをAIにさせるリスク、AIが人間の仕事を奪ってしまうリスク、期待とは異なってAIが人間とは違う挙動をするリスクが生じています。以上をまとめると、AIにリスクが生じる原因は次のようになります。
- 機械学習を用いたAIは帰納的アプローチを用いるため、従来のソフトウエア工学で確立した品質管理の考え方が適用できない
- 開発者にもすべての挙動を予測することができず、学習データに起因したリスクが生じる
- AIが人間と似通っていることや、十分似通っていないことによって生じるリスクがある
(書籍『AIリスク教本 改訂新版』を基に再構成)
[日経クロステック 2026年8月25日付の記事を転載・改題]
日本IBM AI倫理チーム/AI倫理とガバナンス研究会(著)/日経BP/2750円(税込み)