




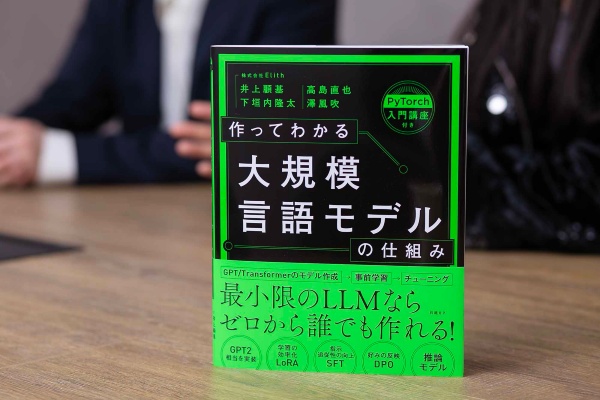
『 作ってわかる大規模言語モデルの仕組み 』を執筆した井上顧基氏と下垣内隆太氏に、大規模言語モデル(LLM)の仕組みを学ぶ意味や、LLMを含む生成AIの最新動向を編集担当者が聞きました。本書では、小規模のLLM(GPT-2/3相当)を自分で実際に作る方法を示しながら、LLMの仕組みを解説します。ChatGPTなどの中で動くLLMは、一度答えた内容を基に次の言葉を生成します。これを知っておくだけでも、いわゆる「プロンプト」の質が上がるといいます。
LLMの仕組みを知っているとプロンプトの質が変わる
今回、執筆された書籍では、ChatGPTやGeminiなどの中で動作する、大規模言語モデル(LLM)の仕組みを詳しく解説しています。一般のユーザーにとって、LLMの中身を知っておくことはどんな意味があるでしょうか。
Elith CAIO / Generative AI Research Engineer 下垣内隆太氏(以下、下垣内) 私の中では、大きく2つあります。実用的な意味と、実用的ではない意味です。
実用的な意味では、生成AIに出す指示、いわゆるプロンプトを書くときに、LLMの中身を知っていると質が上がるというメリットがあります。
本書でも触れているように、LLMは「自己回帰的な生成」をします。前に出したアウトプットを入力として、次のアウトプットを出すということですね。これを理解しているかどうかでプロンプト設計の質が変わります。
例えば、先生がテストの点数をつける場合を考えます。「先に点数をつけてから理由を説明してください」というプロンプトを入れると、ランダムに近い点数を出してから、それっぽい理由を後付けすることがあります。
一方で、「理由を説明してから点数をつけてください」とすると、より納得感のある結果になります。理由を入力として点数をつけるからですね。生成AIの仕組みを知っていると、こうした順序設計ができるようになります。
特に推論(Reasoning)をしないモデルだと、思いついたまま話すような挙動になるので、順番の影響が非常に大きいです。推論モデルの場合は一度考えてから出力するので、多少は影響が小さくなりますが、それでも重要なポイントです。
当社では、一般ユーザー向けにプロンプトエンジニアリングの講座も開いているのですが、LLMの中の仕組みも少しは話します。
もう1つの実用的でない意味のほうはどうでしょうか。
下垣内 そちらは、純粋な知的好奇心が満たされるという点ですね。物理や数学、哲学と同じように、LLMは学ぶこと自体が楽しい分野だと思っています。LLMは今これだけ社会に浸透している技術です。それを理解すること自体が、知的好奇心を満たす営みになるのではないでしょうか。
編集担当者として、私もとても共感します。理屈が分かるたびに、なるほどと思いました。
Elith 代表取締役 CEO/CTO 井上顧基氏(以下、井上) LLMの中身を知る意味について、たとえ話をしてみます。例えば美術館に行ったとします。絵そのものがきれいだ、というのは誰でも分かると思うんですけど、「どこがいいのか」を説明するのはなかなか難しいですよね。でも、美術の知識があると、見るポイントが増えます。ゴッホを見たとき、同時期に描かれた作品同士の関係性を知っていると深い見方ができます。写実的な表現から抽象的な表現に移っていく流れには、戦争などの歴史的背景があったりします。
LLMも同じで、関わっていると楽しくなる。山道やハイキングに行くときも、草花について詳しければ、より楽しめますよね。これから常に身近な存在になるAIについて理解を深めることは、人生をより豊かにしてくれるんじゃないかなと思います。
LLMは「箱」と「入れ方」「入れるもの」で決まる
それでは、そのLLMの中身について教えてください。技術者ではない人向けに、分かりやすく解説してもらえますか。
井上 LLMは、前の文章が与えられたとき、もっともらしい次の言葉を出す、という非常にシンプルな仕組みです。LLMによって、学習したデータ量や、重ねた学習回数に違いはありますが、本質的にはそれだけです。
よく質問と回答に因果関係があるように思われがちですが、実際には因果関係はありません。ある意味、思いつきの積み重ねですね。それっぽい文章がたくさんあれば、そういう文章が出てくる、というだけです。
下垣内 LLMの中身と作り方のポイントを整理すると、大きく3つの要素があります。
1つめは、LLMという「箱」自体、つまり「トランスフォーマー」という現在のLLMの基盤となるアーキテクチャーです。トランスフォーマーには、「アテンション」と呼ぶ機構があり、文章のどこに注目すべきかを見つけます。それを複数の観点で行うのが「マルチヘッドアテンション」です。
2つめがトランスフォーマーという箱に「どう入れるか」。プロンプトなどの文章をうまく分解してトランスフォーマーに次の単語を予測させます。
最後の3つめが「何を入れるか」です。LLMはインターネット上の大量の文章などを使って「事前学習」をします。その後に「事後学習」として、人によって好ましい応答などを入れて学習させます。
これらが組み合わさって、GPTのような賢いモデルができています。
最新の「推論モデル」は「メモ」を取ってから答える
なるほど。良い整理をありがとうございます。さらに、段階的に考えて応答を返す「推論モデル」も、かなり進化してきていますよね。
井上 推論モデルも、上の整理の延長線上にあると思っています。生成AIが出した結果を、さらに使って推論させる、という考え方ですね。テキストを使う場合もあれば、「埋め込みベクトル」を使う場合もありますが、アルゴリズム自体は大きく変わっていません。だから、本書で解説した内容がそのまま土台になる、という点は重要だと思っています。
下垣内 推論モデルでは、ユーザーへの見せ方が大きく変わりました。以前は、LLMが思いついたことをそのまましゃべる、という形でしたが、今のChatGPTなどは「考え中」のようなフェーズがあります。
技術的には、リーズニング(Reasoning)トークンと呼ばれる特殊なトークン(単語)で囲まれた部分に、モデルの内部思考が流れ、その後に発話する形です。メモ帳が付いて、メモしてからしゃべれるようになった、というイメージですね。
これは、数学の問題のように応答の正誤を検証できるタスクで、アルゴリズム的に正しさを評価し、その結果をフィードバックする仕組みが出てきたことが背景にあります。
それによって推論性能が向上し、数学的能力などが伸びました。
書籍でも解説されているように、中国のAIスタートアップ、ディープシークもその流れですよね。
下垣内 そうですね。推論モデルの発展は、OpenAIが2024年9月にo1を出したあたりから始まって、それがディープシークによって、オープンソースや低予算学習でも実現できた、という点が大きな功績だと思います。
先ほどの「メモ」をとるという言い方が分かりやすいと思いました。思いついてすぐ答えを出すのではなく、1回「どうかな」とメモして、考えて、じゃあこの問題はこうやって解こう、と自分で整理してから、その通りに進めていく、というイメージですよね。
下垣内 人間も、しゃべるときは口から出る言葉だけを見ると整理されているように見えますけど、脳内を見たら結構めちゃくちゃだと思うんですよね。
推論(リーズニング)できるようになる前は、その整理されていない脳内をいきなり見られていた状態だったんじゃないかなと思っています。脳の中と外を分けないと、LLMでもどうしようもなかった、という面はあると思います。
確かに。人間も考えている最中の頭の中って、ぐちゃぐちゃですよね。
下垣内 そうなんです。計算ミスをして、間違いに気付いて直して、最後に正しい答えを出す。その途中過程は、見られたくないぐらい混乱しています。
それを許されていなかった頃のLLMの性能が低かったのは、ある意味仕方なかったんじゃないかなと思います。
なるほど。整理中の言葉も全部そのまま出してしまう状態が以前で、推論モデルではちゃんと考えてから出す、という感じですね。
下垣内 その前段階を、明示的にやらせるようになった、ということだと思います。
取材・文/安東一真(日経BOOKSユニット編集部長) 構成/西 倫英(日経BOOKプラス編集) 写真/小野さやか
ChatGPTが使う大規模言語モデル(LLM)「GPT」を一から作りながら、LLMの基本から実装まで体系的に学べる本です。TransformerからGPTまで一から作り、「人間の意図に沿った応答」を生成するアラインメント(SFT、DPO)も実装しながら、その仕組みを学べます。最新の推論強化モデルまでカバー!現代のLLMがどのように作られているのか、その本質をこの1冊で理解できます。
価格:3,630円(税込)
発行日:2026年3月20日
著者名:井上顧基、下垣内隆太、高島直也、澤風吹 著