


マーケティングの現場では、調査データや顧客データを基に意思決定を下す機会が増えています。しかし、数字を見ているつもりでも、その意味や背景を正しく理解できなければ、誤った結論に至る恐れがあります。データ活用が当たり前となった今、統計の基本を身に付けることは、マーケターに欠かせない素養といえるでしょう。本連載では、『 文系マーケターのためのゼロからわかる統計分析 』から一部を転載し、マーケティングに役立つ統計分析の基礎を対話形式で分かりやすく紹介します。今回は、データの特徴を表す「代表値」に焦点を当て、平均値、中央値、最頻値の違いや使い分けを解説。平均値だけでは見えないデータの実像を捉え、より的確な判断につなげるための基礎を学びます。[日経クロストレンド 2026年8月26日付の記事を転載]
図表でデータの特徴をつかむ
西川英彦教授(以下、西川) さて、前回ですが、記述統計では変数が1つの場合と2つの場合で、使う図表や確認するポイントが変わるという話でしたね。では、より基本となる「1つの変数」の場合から説明しましょう。
まず記述統計では、データを図表化して視覚的に大まかな特徴をつかむことから始めます。これは、データの特徴を正しく理解するためにとても大切です。
あっ、確かに、グラフにすると全体の様子がつかみやすいですよね。
西川 変数が1つの場合には、度数分布表や棒グラフ、ヒストグラムなどが使われます。ただし、どの図表が見やすいかは、変数の種類によって変わります。まずは、質的変数の例から見てみましょう。
その前に、度数分布表って、何ですか?
西川 度数とは、ある値に対応するデータの個数のことです。その度数を一覧に整理したものが「度数分布表」です。
例があるとうれしいです。
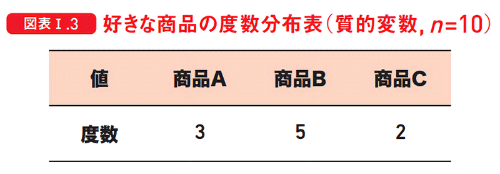
西川 そうですよね。例えば、10人に商品A・B・Cのうち「好きな商品」を聞いたところ、結果が次のように「A、A、A、B、B、B、B、B、C、C」だったとします。
えっと、Aが3人で、Bが5人、Cが2人ということでしょうか?
西川 その通りです。A・B・Cに対して、それぞれ3・5・2という人数が「度数」です。これを表にまとめたものが「度数分布表」です(図表Ⅰ.3)。なお、図表タイトルの「n」の記号はサンプルサイズ、つまりデータの個数が10人であることを表します。
よく見る表ですね。
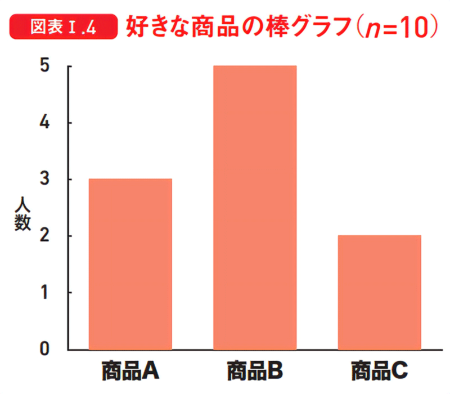
西川 そして、度数分布表を見やすく図にしたものが、棒グラフです(図表Ⅰ.4)。
これもよく作ります。
量的変数はヒストグラムで分布を見る
西川 今のは質的変数の例でした。次に量的変数の例を見ましょう。
質と量で違うんですね。
西川 はい。量的変数には連続変数と離散変数がありましたね。ここでは、連続変数の例として、スマホ利用時間を見てみましょう。
長い人も短い人もいて、数字にかなり幅が出そうですね。
西川 そうですよね。演習用の架空データですが、会員10人の1日のスマホ利用時間が、「115、139、140、158、159、160、175、180、200、220」分だったとします。これを度数分布表にしてみます(図表Ⅰ.5)。
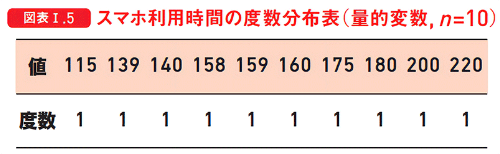
度数分布表にしても、バラバラでわかりにくいですね。
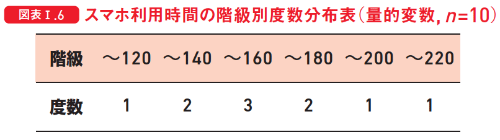
西川 そこで、分布をつかみやすくするために、20分ごとの「区間」にまとめてみます(図表Ⅰ.6)。区間のことを階級といいます。階級の幅は、データに合わせて、把握しやすいように調整します。
こっちのほうが、どのあたりに多いのかが見やすいですね。
西川 こうした階級ごとの度数をグラフ化したものがヒストグラムです。スマホ利用時間のような連続変数は「連続的に変化するデータ」なので、縦棒の間にはすき間はありません(図表Ⅰ.7)。
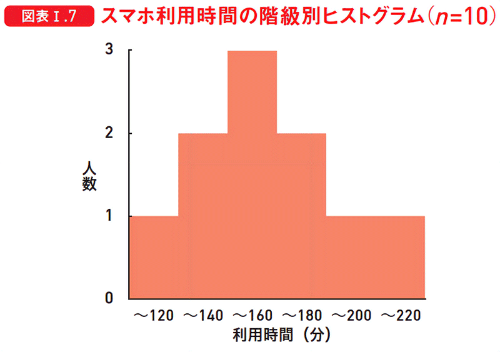
なるほど、縦棒がくっついているのは、そういう理由なんですね。
西川 一方で、購入数や来店客数のような離散変数は、値が0、1、2、3……と分かれているので、値ごとの度数を棒グラフで表すことが多いです。棒グラフでは、値と値を区別するため、縦棒の間にすき間を空けています。
つまり、連続変数はヒストグラム、離散変数は棒グラフで見ることが多いんですね。
西川 その通りです。ただし、離散変数でもデータの値の種類が多い場合は、ヒストグラムで分布を見ることもあります。データの値の種類が少ない場合は棒グラフ、多い場合はヒストグラム、と使い分けると考えるといいでしょう。
離散変数は棒グラフだけとは限らないんですね。
西川 これで、変数が1つの場合の図表化は説明できました。数が2つの場合の図表化である散布図は、別の章で説明します。しかし、図表だけでは「要するにどういうデータなのか」と、一言で特徴を説明することはできません。
確かに、図表はわかりやすいですが、一言で特徴を伝えるとなると別の話ですね。
「基本統計量」でデータの特徴をつかむ
西川 そのため、データ全体の情報を1つの値に要約する必要があります。この要約された数値のことを「基本統計量」と呼びます。
この基本統計量にも、変数が1つの場合と2つの場合があるんですか?
西川 はい。まず1つの変数の特徴を表す基本統計量には「代表値」と「散布度」があります。中でも最も基本となるのが、データ全体を1つの値で示す「代表値」です。
データ全体を、1つの値だけで代表するんですか?
西川 はい。ただし「代表」といっても、代表選手や代表商品のような「優れたもの」という意味ではありません。個々のデータの値との差が小さく、そのデータの特徴を最も典型的に表す値という意味での代表です。
もしかして、平均のことですか?
西川 そうです。最もよく使われる代表値が「平均」です。
確かに、データを確認するときって「平均でどれくらい?」って、まず聞きますよね。
西川 そうですね。それで、平均とは、すべてのデータを合計して、サンプルサイズn(データの個数)で割った値です。
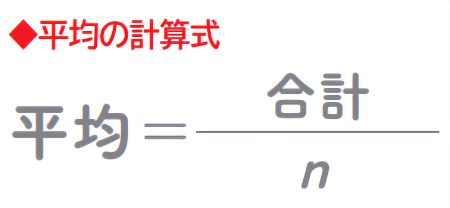
さすがに、この計算式はよく知っています。
西川 では、先のスマホ利用時間の平均を計算してみてください。
合計すると「115+139+140+158+159+160+175+180+200+220=1646」で、全体は10人なので「1646÷10=164.6」で、164.6分ですね?
西川 その通りです。スマホ利用の平均時間は164.6分と、一言でデータの特徴を説明できますね。
平均には、図表にはない、簡潔なわかりやすさがありますね。
西川 平均以外にも、データを大きさの順に並べた真ん中の値「中央値」や、最も頻繁に表れる値「最頻値」も、代表値の仲間です。先のデータの中央値は何ですか?
データが「115、139、140、158、159、160、175、180、200、220」で、利用時間順になっているので確認しやすそうです。
西川 そうですね。もし小さい順に並んでいない場合は、並べ直してから調べます。
あれ、10個は偶数なので、ちょうど真ん中の値はありませんよ。
西川 データ数が偶数の場合は、中央の2つの値の平均が、中央値となります。この例では5番目と6番目の値の平均を求めます。
なるほど。じゃあ中央値は「(159+160)÷2=159.5」、つまり159.5分ですね。
西川 そうです。では、最頻値はどうでしょうか。ただし、スマホ利用時間のような連続変数では、同じ値が何度も出るとは限らないため、最頻値はわかりにくいことがあります。
確かに、先ほどの度数分布表を見ると、同じ値は出ていませんね。
西川 その通りです。そこで、階級別度数分布表やヒストグラムから、最も度数の多い階級を確認します。図表Ⅰ.6のスマホ利用時間の階級別度数分布表を見てください。
その度数分布表を見ると、160分までの階級が一番多いですね。
西川 そうです。正確には、「140分を超えて160分以下」の階級です。階級にまとめたデータを見て、最も度数の多い階級を確認します。そして、その階級の中央の値である階級値を、最頻値の目安として扱います。
つまり、今回の最頻値は「(140+160)÷2=150」で、150分でしょうか?
西川 その通りです。今回のデータでは、平均164.6分、中央値159.5分で、階級から見る最頻値の目安は150分といえます。
少し値は違いますが、代表値は平均でいいですよね?
西川 確かに、一般的には平均が使われます。平均と中央値、最頻値が近ければ、平均を代表値として示しやすいです。ただし、今回のように少し違いがある場合は、平均を示しつつ、中央値や最頻値の目安も併せて説明するとよいでしょう。
平均だけを見ればよい、というわけではないのですね。
西川 そうです。さらに、図表にした際に、他のデータと比べて極端に大きいか小さい値である「外れ値」があることがわかった場合は、平均が外れ値に引きずられやすく、代表値として使いにくくなることがあります。
引きずられやすい?
西川 スマホ利用時間の最後のデータが、もし220分ではなく、1000分だったらどうでしょうか?
計算すると、「(115+139+140+158+159+160+175+180+200+1000)÷10=242.6」。平均242.6分で、変更前の164.6分に比べて、確かに外れ値に引きずられています。
西川 外れ値がある場合は、中央値が代表値としてよく使われます。また、質的変数の場合は、平均や中央値が算出できないので、最頻値を使います。
確かに、「好きな商品」のようなデータでは、平均や中央値は計算できませんね。
代表値だけではわからない「ばらつき」も確認する
西川 こうした代表値だけでなく、1つの変数の特徴を見るときは「散布度」も重要です。
散布度って、ばらつきのことですか?
西川 はい。散布度には「分散」「標準偏差」などがあります。
いきなり難しそうな言葉が出てきました……。
西川 これらについては別の章で、事例をもとに、わかりやすく説明するので安心してくださいね。
はい、お願いします。
西川 以上で、変数が1つの場合の記述統計の説明を終わります。最初にグラフなどの図表でデータを視覚的に確認し、その上で代表値や散布度といった基本統計量を計算して、データの特徴を把握することを学びました。
まずは見た目で確認して、そのあとに数字で特徴をつかむわけですね。
西川 そうです。変数が2つの場合の記述統計でも同じで、まずは図表で確認した上で、相関係数などの基本統計量を計算して、データの特徴を確認します。
相関係数? また知らない言葉が出てきました……。
西川 それについても別の章で説明しますので、少し待っていてください。さて、記述統計については、だいたい理解できたでしょうか?
はい。記述統計を使えば、データを整理して特徴をつかめるんですね。アンケートなど大量のデータでも、その特徴が確認できれば、マーケティングに活用できますね。
西川 その通りです。
では、もう1つの「推測統計」では、どんなことをするのですか?
西川 それについては、「推測統計」のパートで詳しく解説します。
(「散布図」や「分散」「標準偏差」などの詳しい解説は、『文系マーケターのためのゼロから分かる統計分析』をお読みください)
- 南風原朝和(2002)『心理統計学の基礎 -- 統合的理解のために』有斐閣
- 山田剛史・杉澤武俊・村井潤一郎(2008)『Rによるやさしい統計学』オーム社
- 山田剛史・村井潤一郎(2004)『よくわかる心理統計』ミネルヴァ書房
- 吉田寿夫(1998)『本当にわかりやすいすごく大切なことが書いてあるごく初歩の統計の本』北大路書房
- 総務省統計局「中心的な傾向を捉える」『なるほど統計学園』
西川英彦、佐保圭(著)、日経BP、2420円(税込み)